近日,由人工智能与教育新形态实验室青年教师何晨瑄及团队完成的学术论文“Feedback More Than Scoring: A Multi-Agent System for Reading Comprehension Assessment”以及“Knowledge-Graph Grounding in Repeated LLM Feedback: A Randomized Field Experiment on Learning and Perceptions”被2027年美国教育研究协会(American Educational Research Association,AERA)年会录用,将以论文报告形式在Paper Session “Students at the Center: How Learners Experience AI Tools and Tutors”以及“Human–AI Partnerships in Educational Assessment: Innovations in Scoring, Feedback, and Learning Analytics”进行交流,实验室为第一完成单位。AERA是全球重要的教育研究组织,其一年一度的年会是国际教育研究领域具有重要影响力的学术会议。
Feedback More Than Scoring: A Multi-Agent System for Reading Comprehension Assessment
大模型应用于自动简答题评分(ASAG)教育评价领域已经展示出巨大潜力,但目前基于LLM的现有评分系统往往侧重评分结果,无法提供有针对性的具体反馈,许多方法依赖单一模型同时生成分数与评分理由,评分依据难以追溯,存在证据黑箱、学生作答问题诊断不足等问题。针对这一问题,团队基于证据中心设计与形成性反馈理论,提出了一种面向阅读简答题的多智能体评分与反馈系统。该系统通过多智能体分工协作,分别完成评分细则对齐、文本证据核查和作答问题诊断,综合生成最终分数、评分理由与修改建议。该方法在提供评分依据的同时,能够识别学生作答中的具体问题并生成针对性修改建议。
基于148名高中生、围绕四道不同类型的阅读理解简答题的实验结果表明,系统评分与教师评分总体较为接近,四道题的QWK介于0.664至0.966之间,四位语文教师对系统给予了积极评价。该研究为推动自动评分从单一分数输出向评分解释、问题诊断与形成性反馈相结合提供了新的研究思路。
Knowledge-Graph Grounding in Repeated LLM Feedback: A Randomized Field Experiment on Learning and Perceptions
大语言模型能够根据学生作答生成个性化反馈,但在多轮测评与反馈中,如何持续围绕学生的知识薄弱环节提供准确、一致的指导,以及这种指导能否促进后续学习,仍需实证检验。已有研究较多关注单次反馈或生成文本的质量,对个性化反馈在连续教学过程中的效果及其变化,缺乏充分的纵向证据。
针对这一问题,团队提出结构化知识子图增强的大模型个性化反馈方法。该方法围绕学生薄弱知识点,从学科知识图谱中检索先修知识、关联概念及其关系,形成与学习问题相对应的结构化子图,为模型解释学习困难、生成针对性建议提供明确的知识依据。研究在保持模型、诊断信息与反馈安排一致的条件下,对比增强反馈与常规大模型反馈,将每轮反馈与下一轮同知识点测评对应,考察这种反馈方式在连续评价中的学习支持效果及其跨轮次变化。
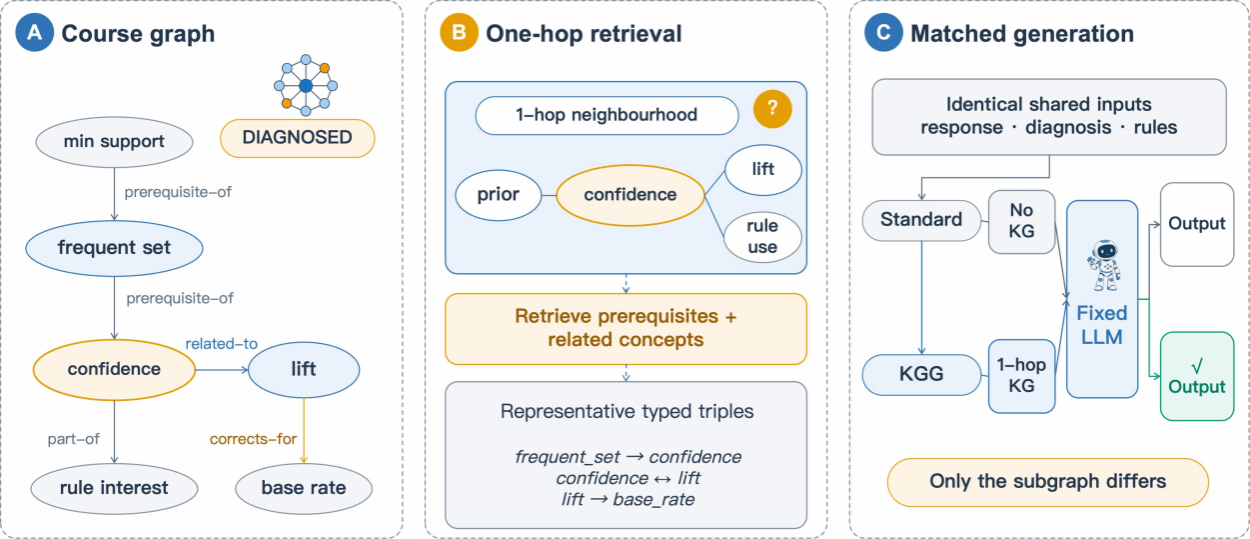
基于113名本科生、围绕五轮测评与反馈开展的随机实验结果表明,对于前一轮反馈涉及的知识点,增强反馈组在后续测评中表现更好,且这一优势随轮次推进而扩大,学生对反馈的可信度评价也更高。该研究为结构化知识子图增强的模型反馈在连续个性化评价中的应用提供了方法参考与实验证据。

 友情链接
 联系我们